[Spring] WebFlux 도입에 관한 고민 — Spring MVC와의 비교 및 주의사항
Spring 5.0에서 도입된 리액티브 웹 프레임워크 WebFlux의 동작 원리와 Spring MVC(명령형)와의 장단점 비교, 도입을 고려해야 할 실무 시나리오, 그리고 블로킹 DB(JDBC) 혼용 시 주의해야 할 병목 함정을 정리합니다.
Spring WebFlux란?
WebFlux는 웹 환경에서 Reactor 기반의 비동기 스트리밍 처리를 지원하기 위해 Spring 5.0부터 도입된 리액티브 웹 프레임워크입니다.
Non-Blocking I/O와 Reactive Streams(Backpressure 포함) 규격을 기반으로 적은 스레드 리소스로도 동시 다발적인 대규모 요청을 효율적으로 처리하기 위해 설계되었습니다. 기존의 저수준 Reactive Streams API를 직접 다루는 대신, Mono·Flux와 풍부한 연산자(Operators)를 활용해 비동기 파이프라인을 선언적으로 작성할 수 있습니다.
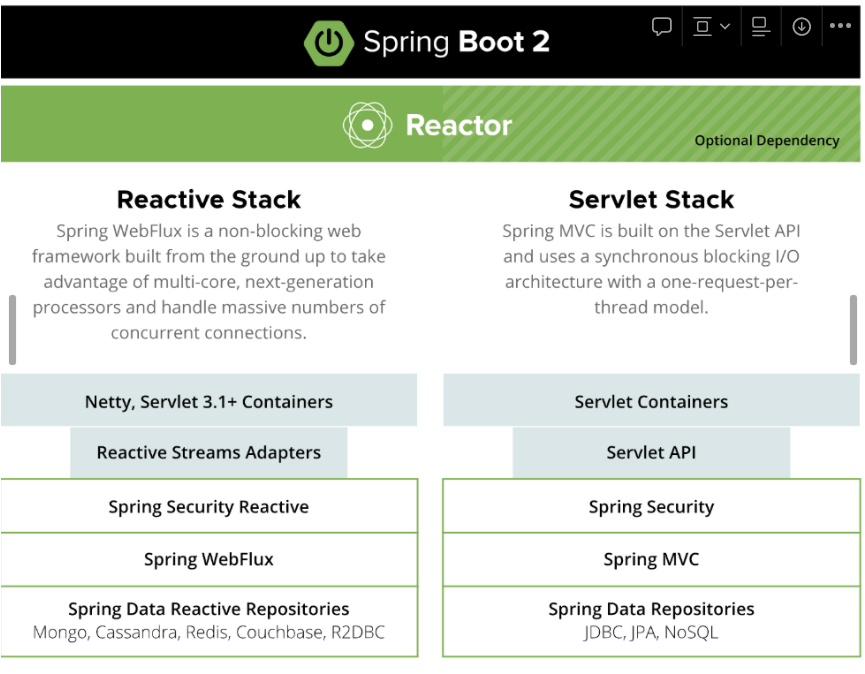
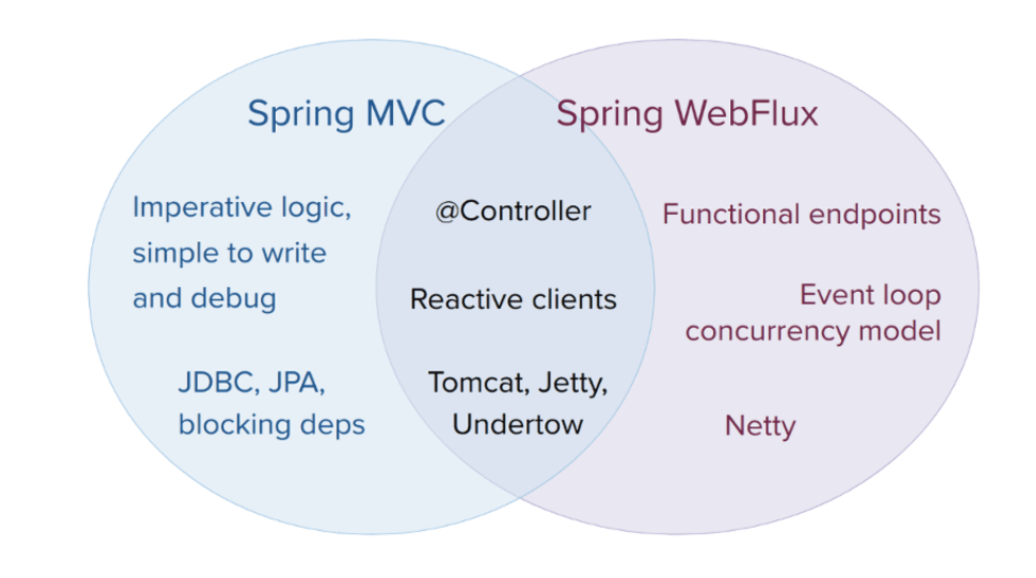
Spring MVC vs Spring WebFlux
기존의 Spring MVC는 요청당 하나의 스레드가 할당되는 멀티스레드 기반 명령형(Imperative) 프로그래밍 모델입니다. 비즈니스 로직을 단계별로 명확하게 나누어 작성할 수 있고, 스택 트레이스 디버깅이나 유지보수가 직관적이라는 큰 강점이 있습니다.
반면 WebFlux는 비동기 스트림(Mono, Flux)을 조합해 파이프라인을 구성하는 함수형·선언형 프로그래밍 방식을 따릅니다. 스레드가 이벤트 루프 사이를 넘나들며 비동기로 실행되기 때문에, 스레드 로컬(ThreadLocal) 기반 컨텍스트 전파나 에러 스택 추적·디버깅 난이도가 상대적으로 높습니다.
// WebFlux 함수형 리액티브 파이프라인 예시
basketFlux.concatMap(basket -> {
    final Mono<List<String>> distinctFruits =
            Flux.fromIterable(basket).distinct().collectList();

    final Mono<Map<String, Long>> countFruitsMono = Flux.fromIterable(basket)
            .groupBy(fruit -> fruit)
            .concatMap(groupedFlux -> groupedFlux.count()
                .map(count -> {
                    final Map<String, Long> fruitCount = new LinkedHashMap<>();
                    fruitCount.put(groupedFlux.key(), count);
                    return fruitCount;
                })
            )
            .reduce((accumulatedMap, currentMap) -> {
                Map<String, Long> merged = new LinkedHashMap<>(accumulatedMap);
                merged.putAll(currentMap);
                return merged;
            });

    return Flux.zip(distinctFruits, countFruitsMono, FruitInfo::new);
}).subscribe(System.out::println);
그럼에도 WebFlux 도입을 고려할 만한 4가지 환경
단순히 "최신 기술이라서" 혹은 "무조건 빨라질 것 같아서" WebFlux를 도입하기보다, 다음과 같이 아키텍처 특성이 맞물릴 때 진가를 발휘합니다.
- 데이터를 실시간 스트리밍(SSE, WebSocket 등)으로 지속 전송해야 하는 경우
- 비즈니스 로직 대부분이 외부 업스트림 API 호출 응답을 대기하는 I/O 중심 서비스인 경우 (예: API Gateway, BFF 오케스트레이션 서버)
- 여러 외부 API를 병렬로 호출하고 결과를 취합해 내려주는 집계 시스템
- 대량의 동시 연결에서 발생하는 스레드 컨텍스트 스위칭 비용과 메모리 점유율 부담을 줄여야 하는 경우
WebFlux를 제대로 쓰기 위한 핵심 원칙: End-to-End Non-Blocking
WebFlux는 애플리케이션 전체 파이프라인이 비동기 Non-Blocking으로 흐를 때만 의도한 성능을 낼 수 있습니다.
주변 지인이 전통적인 RDB(JDBC)와 WebFlux를 결합해 실시간 교통정보 스트림을 전송하는 시스템을 구축했다가 DB 커넥션 고갈 및 응답 지연으로 장애를 겪은 사례가 있었습니다.
아무리 웹 컨트롤러 단에서 WebFlux로 비동기 처리를 하더라도, 내부에서 호출하는 JDBC 기반 RDB 드라이버가 블로킹(Blocking) 방식으로 동작하면 결국 이벤트 루프 스레드가 블로킹되면서 심각한 병목이 발생하기 때문입니다.
따라서 WebFlux를 도입할 때는 데이터 저장소 계층까지 논블로킹 스택을 맞추어야 합니다.
- RDB가 필요하다면 JDBC 대신 R2DBC(Reactive Relational Database Connectivity) 사용
- Redis(Lettuce Reactive), MongoDB Reactive 등 Non-Blocking 드라이버를 지원하는 저장소 활용
실제로 사내에서 외부 API 호출을 중계하는 챗봇 프로젝트를 진행했을 때도, 이러한 이유 때문에 RDB 대신 WebFlux + Reactive Redis 조합으로 아키텍처를 설계해 운영했던 경험이 있습니다.
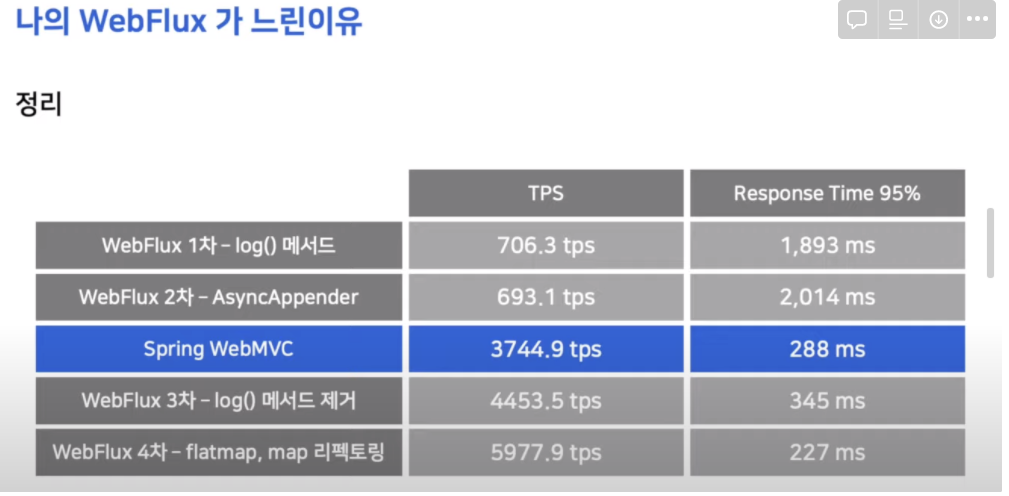
참고 영상: 어느 기업에서 WebFlux를 도입했다가 오히려 성능이 느려졌던 이유 (YouTube) — 파이프라인 어딘가에 블로킹 코드가 단 하나라도 섞여 있으면 WebFlux 도입의 의미가 퇴색됩니다.
[Spring] Redis 개요와 세션 클러스터링, Spring Data Redis 연동
NEXT LOG →[Spring] PRG 패턴에서 redirect:/가 동작하지 않는 이유 (@ResponseStatus 함정)